LLM 추론의 나침반, 프로세스 보상 모델 PRM
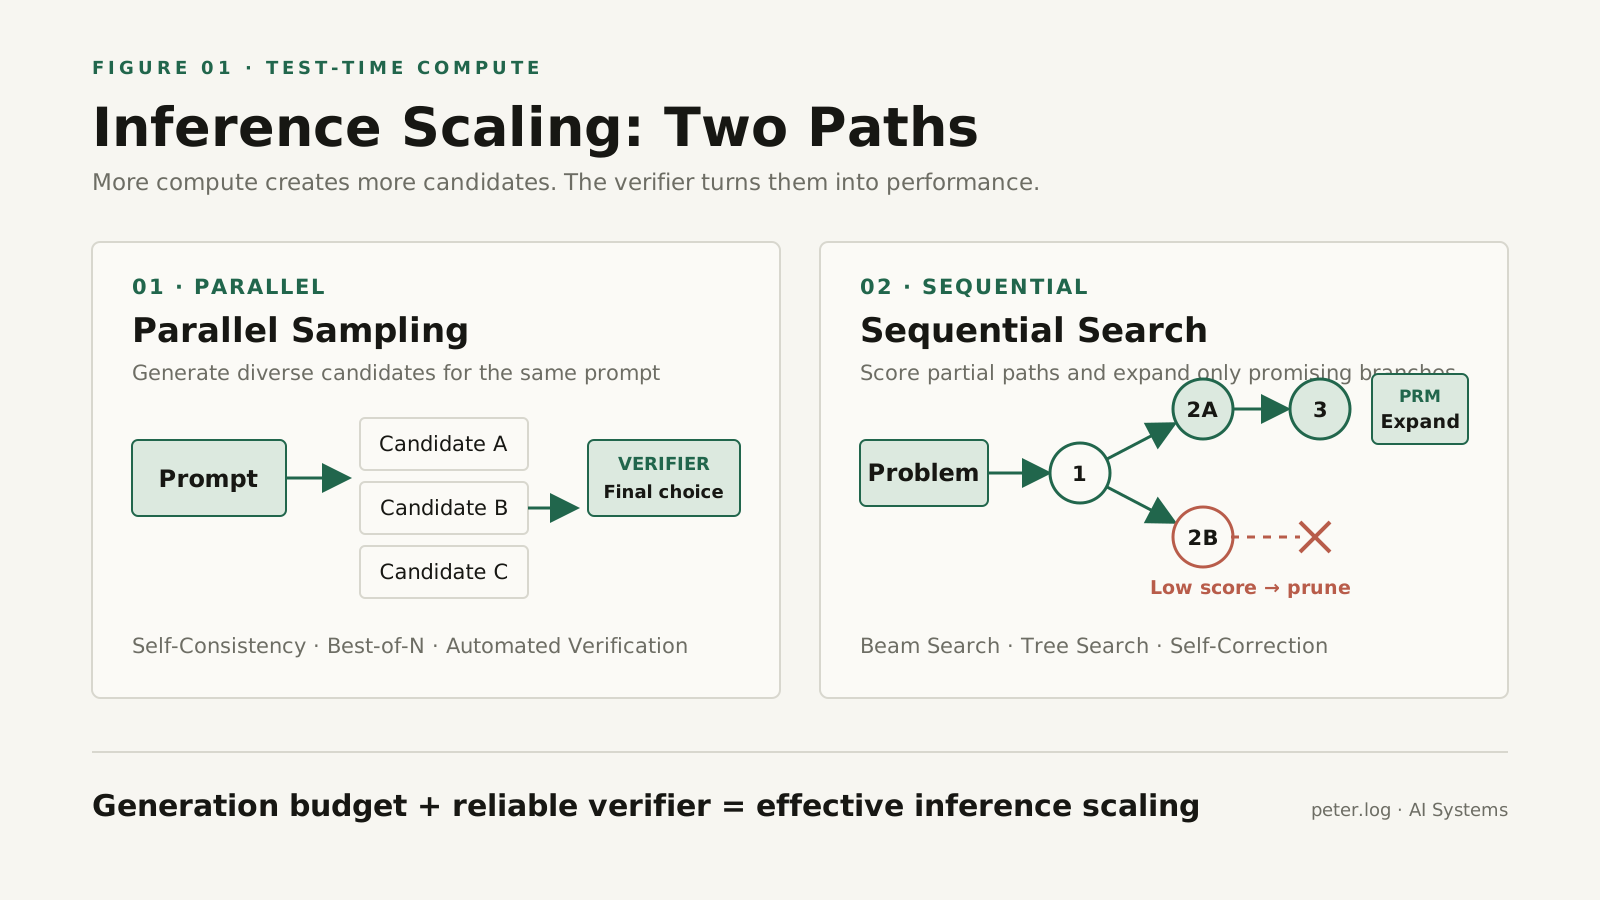
추론 연산량을 늘리는 것만으로는 충분하지 않다. PRM이 추론 단계를 평가하고 Best-of-N 후보를 다시 정렬하며 탐색 경로를 고르는 원리를 살펴본다.
Archive · 03
문제를 해결한 결과보다, 어떤 질문과 기준으로 선택했는지를 남깁니다.
추론 연산량을 늘리는 것만으로는 충분하지 않다. PRM이 추론 단계를 평가하고 Best-of-N 후보를 다시 정렬하며 탐색 경로를 고르는 원리를 살펴본다.
주식을 보유하고 있으면 장이 끝난 뒤에도 생각이 멈추지 않는다.
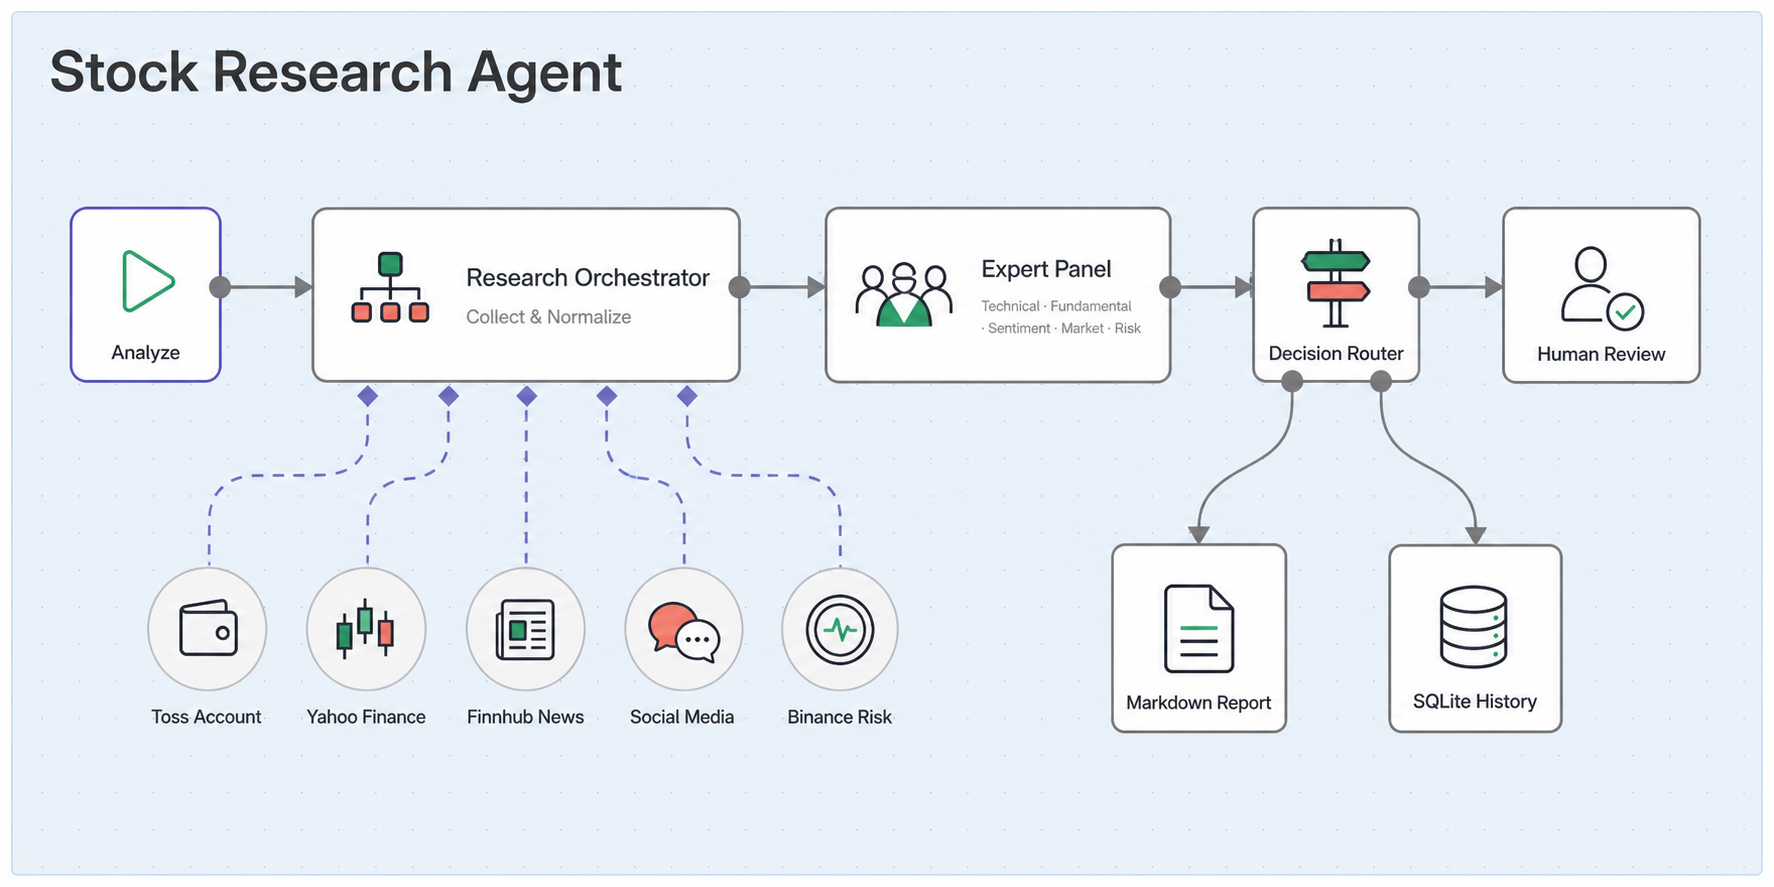
LLM을 활용하는 방식은 다양하다. 이번 글에서는 그중에서도 사용자에게 직접 보여줄 자연어를 생성하는 태스크에 초점을 맞춰보려 한다.