여러 답을 뽑는다고 LLM의 성능이 저절로 오르지는 않는다. 그중 잘못된 추론을 걸러내고 믿을 만한 경로를 골라야 비로소 추가 연산이 의미를 갖는다. 이 글은 LLM 추론과 AI 에이전트의 검증 구조에 관심 있는 개발자를 위해 프로세스 보상 모델(Process Reward Model, PRM)의 작동 원리를 정리한다. Best-of-N, ORM과 PRM의 차이, 단계 점수 집계, PRM800K, 액티브 러닝까지 다룬다.
한 문장으로 줄이면 이렇다. 추론 스케일링의 병목은 생성량보다 검증 정확도에 가깝다.
요지만 먼저 말하면
Outcome Reward Model, ORM은 최종 결과를 평가한다. PRM은 중간 추론 단계를 하나씩 평가한다. 후보를 여러 개 만드는 Best-of-N에서는 좋은 후보가 생성됐는지만큼 그 후보를 찾아낼 검증기가 정확한지도 중요하다.
단계 점수를 합치는 방법은 하나로 정해져 있지 않다. OpenAI의 PRM800K 연구는 각 단계가 올바를 확률을 모두 곱했다. 최솟값이나 평균도 쓸 수 있지만, 풀이 길이와 점수 보정 상태에 따라 후보 순위가 달라진다.
코딩과 에이전트 시스템이라면 테스트나 실행 결과처럼 확실한 신호를 먼저 써야 한다. PRM은 정답을 생성하는 모델이라기보다 제한된 추론 예산을 어느 경로에 쓸지 정하는 검증기에 가깝다.
추론 스케일링에서는 생성과 선택을 함께 봐야 한다
LLM 성능을 높이는 가장 익숙한 방법은 더 큰 모델을 학습하는 것이다. 모델 크기와 데이터, 학습 연산량 사이에 일정한 성능 향상 관계가 있다는 사실은 Scaling Laws for Neural Language Models과 Chinchilla 논문을 통해 잘 알려졌다.
새 모델을 학습하지 않고 추론 단계에 더 많은 연산량을 투입하는 방법도 있다. 이를 테스트 타임 컴퓨트 스케일링(Test-Time Compute Scaling) 또는 인퍼런스 스케일링(Inference Scaling)이라고 부른다.
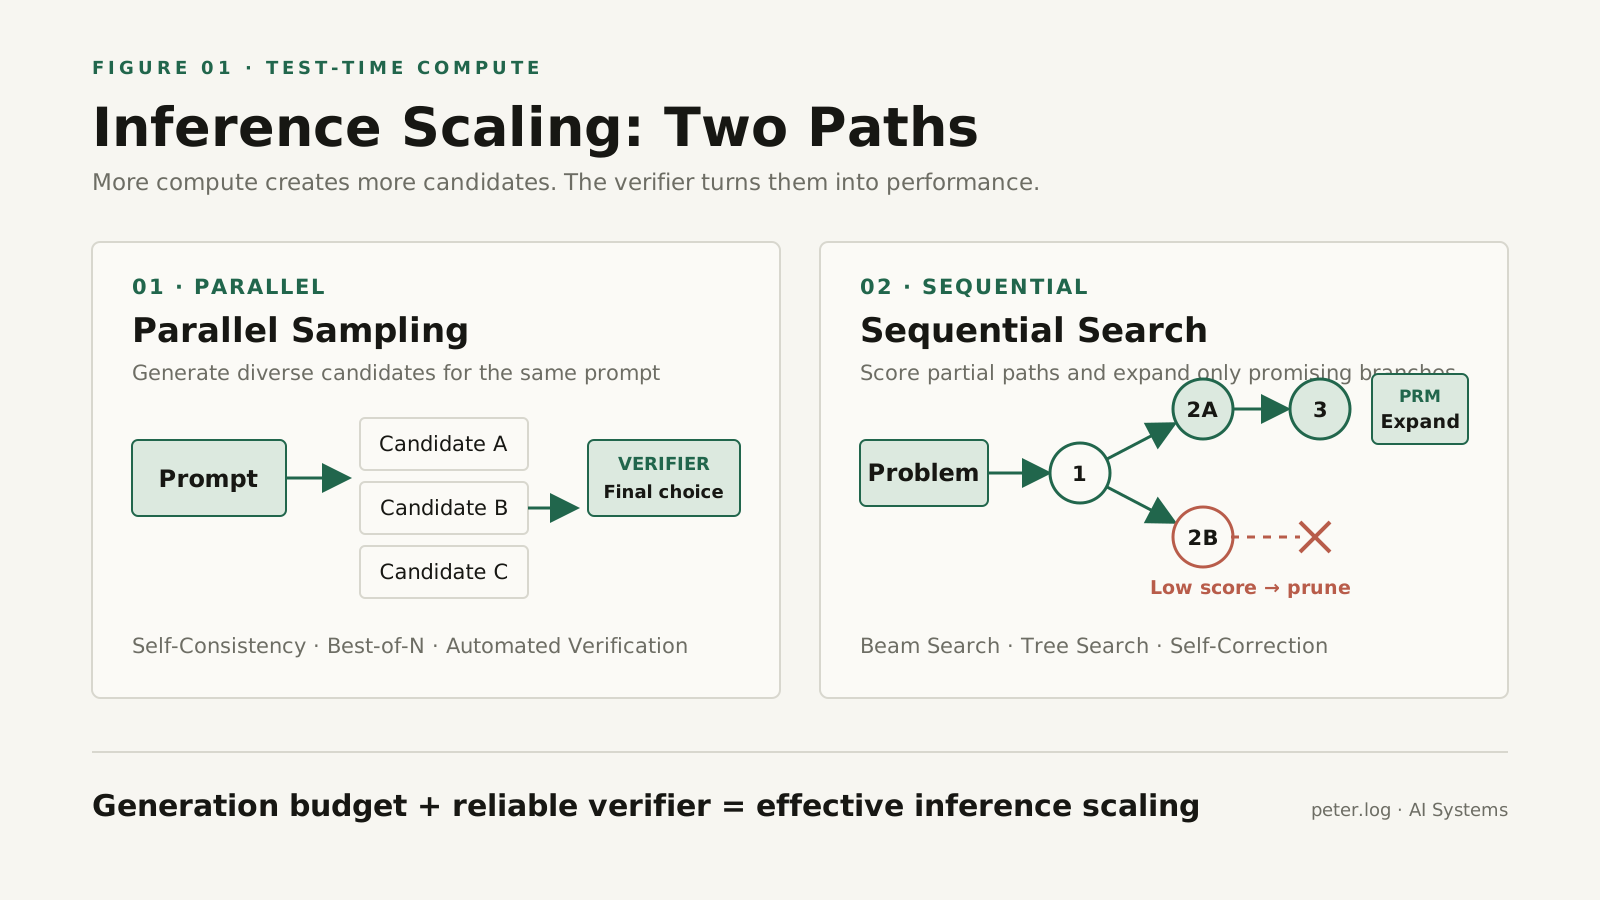
Figure 1. 병렬 샘플링과 순차 탐색 모두 생성된 경로를 평가할 검증기가 있어야 실제 성능 향상으로 연결된다.
한 가지 방법은 같은 질문에 서로 다른 Temperature나 Seed를 적용해 답변 후보를 여러 개 만드는 병렬 샘플링이다.
질문
 ├─ 후보 A
 ├─ 후보 B
 ├─ 후보 C
 └─ 후보 D
      ↓
   검증 및 선택
      ↓
   최종 답변
가장 단순한 선택 방법은 다수결이다. Self-Consistency는 서로 다른 추론 경로를 샘플링한 뒤 가장 일관되게 등장한 답을 고른다.
후보를 늘리면 적어도 하나의 정답이 포함될 가능성도 커진다. Large Language Monkeys에서 DeepSeek-Coder-V2-Instruct는 SWE-bench Lite 문제를 한 번만 시도했을 때 15.9%를 해결했다. 250개를 샘플링하자 하나 이상의 정답이 포함된 비율은 56%까지 올랐다.
여기서 56%는 검증기가 실제로 정답을 선택한 비율이 아니다. 후보 안에 정답이 존재하는 coverage다. 정답을 생성하는 일과 그 답을 골라내는 일은 따로 봐야 한다. 코딩 문제에는 자동 테스트라는 강한 판별 수단이 있지만 자연어 분석처럼 명확한 검증기가 없는 영역에서는 후보를 계속 늘려도 선택 성능이 일정 수준에서 멈출 수 있다.
다른 방법은 완성되지 않은 여러 경로를 유지하면서 유망한 쪽만 확장하는 순차 탐색이다.
문제
  ↓
1단계
 ├─ 2A 단계 → 높은 점수 → 계속 확장
 └─ 2B 단계 → 낮은 점수 → 탐색 중단
Beam Search나 Tree Search를 쓰면 점수가 낮은 가지를 일찍 버릴 수 있다. Scaling LLM Test-Time Compute Optimally은 문제 난이도에 맞춰 추론 연산량을 다르게 배분해야 한다고 설명한다. 어떤 문제는 후보를 많이 생성하는 편이 낫고, 어떤 문제는 중간 경로를 고치며 탐색하는 편이 유리하다.
두 접근은 결국 같은 질문과 마주친다. 아직 끝나지 않은 추론이 제대로 된 방향으로 가는지는 누가 판단할까?
ORM은 실패를 판정하고 PRM은 실패 지점을 찾는다
ORM은 전체 풀이가 끝난 뒤 최종 결과를 평가한다. 다음 문제를 예로 들어보자.
가 을 나누도록 하는 가장 큰 자연수 를 구하라.
정답은 100!에 포함된 소인수 2의 개수를 세면 얻을 수 있다.
모델이 마지막 항인 을 빠뜨렸다고 해보자.
1단계: 100!에 포함된 소인수 2의 개수를 센다.
2단계: 50 + 25 + 12 + 6 + 3 = 96
3단계: 따라서 k = 96
ORM은 최종 답변이 틀렸다고 판정한다. 다만 어느 단계에서 문제가 시작됐는지는 알려주지 않는다.
전체 풀이 → 최종 답변 96 → 오답
PRM은 각 단계에 따로 점수를 준다.
1단계 → 0.97
2단계 → 0.08
3단계 → 0.11
두 번째 단계에서 점수가 급격히 떨어졌다. 오류가 이 지점에서 생겼을 가능성이 크다.
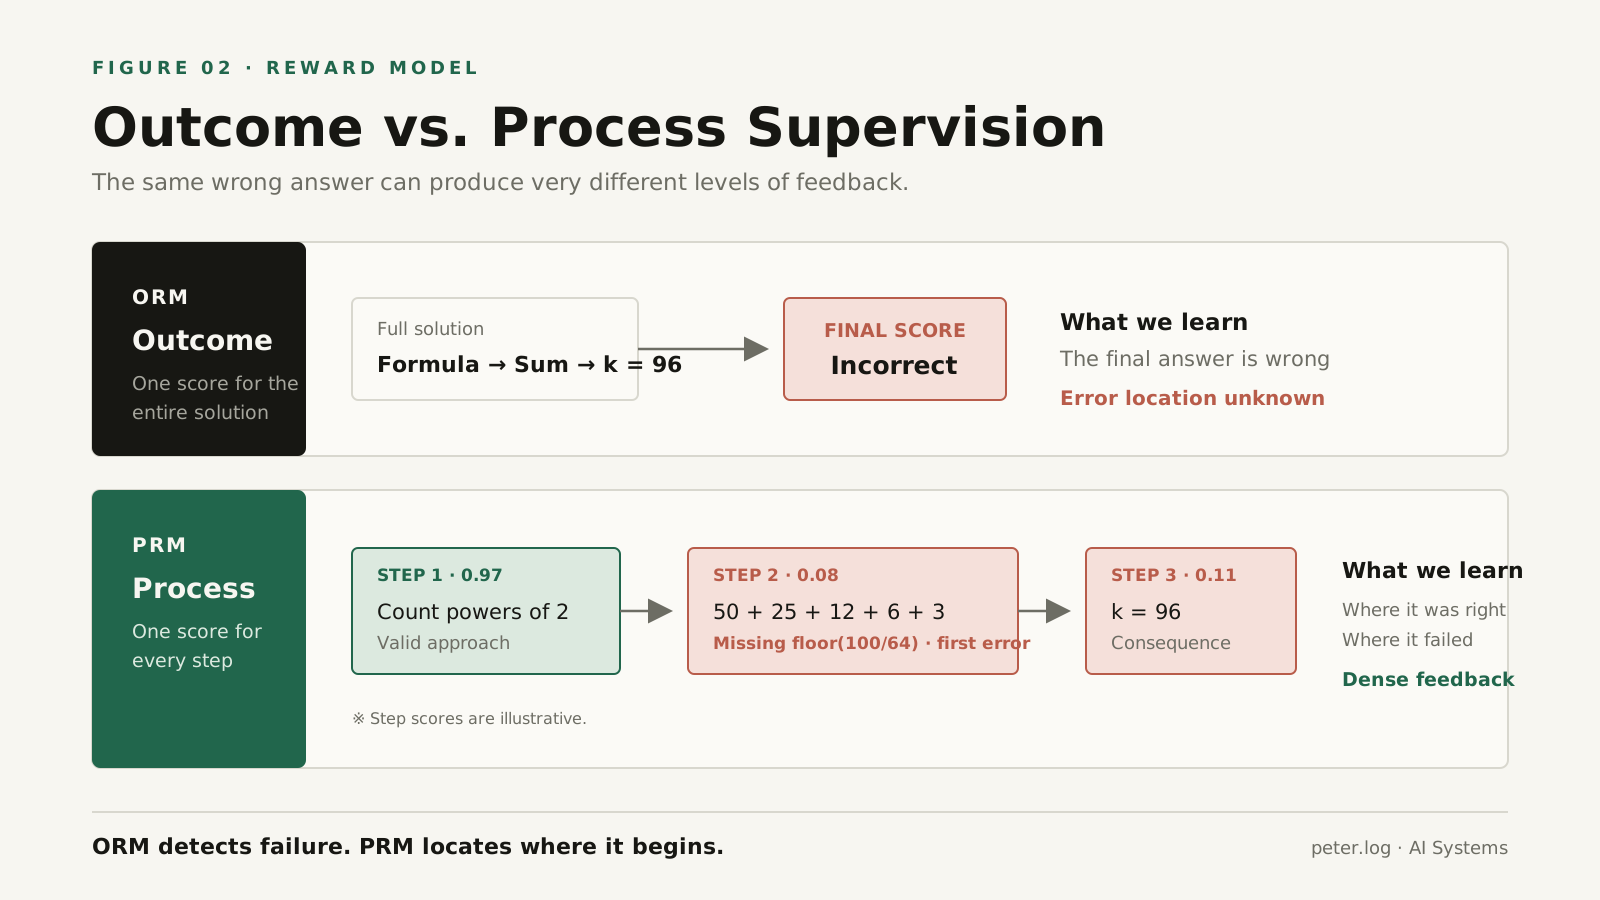
Figure 2. ORM은 최종 오답을 판정한다. PRM은 항이 누락된 최초 오류 단계까지 찾을 수 있다. 그림의 점수는 설명을 위한 예시다.
PRM이 추정하는 값은 다음처럼 표현할 수 있다.
과정 감독은 오류가 생기기 전까지 어느 단계가 맞았는지 알려준다. 최종 실패의 원인을 특정 행동에 연결하고, 잘못된 부분 경로를 완성 전에 제거하는 데도 쓸 수 있다. 결과는 맞았지만 추론이 잘못된 답도 가려낼 여지가 생긴다. 과정 감독과 결과 감독의 초기 비교는 Solving Math Word Problems with Process- and Outcome-Based Feedback에서 확인할 수 있다.
PRM은 풀이의 각 단계에 점수를 매긴다
학습용 풀이는 줄바꿈이나 별도의 Step Token을 기준으로 나눈다.
Step 1: 문제를 인수분해 문제로 바꾼다.
Step 2: 각 소인수의 지수를 계산한다.
Step 3: 계산한 값을 더한다.
단계 경계가 명확해야 어느 지점의 점수를 예측할지도 정할 수 있다. 사람이나 자동 검증기는 각 단계의 타당성을 평가한다. PRM800K에서 +1은 올바르고 합리적인 단계, 0은 명확한 오류는 아니지만 애매하거나 진전이 없는 단계, -1은 틀렸거나 불합리한 단계를 뜻한다.
PRM은 문제와 지금까지 생성된 풀이를 입력받고 현재 단계가 올바를 확률을 반환한다.
문제 + Step 1               → 0.97
문제 + Step 1 + Step 2      → 0.92
문제 + Step 1 + Step 2 + 3  → 0.08
구현에 따라 별도의 분류 Head를 붙이거나 정답·오답을 나타내는 토큰의 확률을 학습한다. OpenAI의 Let’s Verify Step by Step에서는 각 단계 마지막 토큰 다음에 해당 단계의 정확성을 예측하도록 PRM을 학습했다. 단계별 점수는 전체 풀이에 대한 한 번의 Forward Pass로 얻는다.
단계 점수는 어떻게 하나로 합칠까
여러 후보를 비교하려면 단계별 점수를 하나의 값으로 줄여야 한다.
| 집계 방식 | 의미 | 장점 | 주의점 |
|---|---|---|---|
| 확률의 곱 | 모든 단계가 맞을 확률 | 모든 단계를 반영한다 | 긴 풀이에 불리할 수 있다 |
| 최솟값 | 가장 취약한 단계의 점수 | 치명적인 단일 오류에 민감하다 | 보정 오류 하나에 전체 점수가 좌우된다 |
| 평균 | 단계 점수의 평균 | 비교적 안정적이다 | 중요한 오류가 희석될 수 있다 |
| 마지막 점수 | 최종 Prefix의 점수 | 구현이 단순하다 | 중간 오류를 충분히 반영하지 못할 수 있다 |
PRM이 반드시 최솟값을 쓰는 것은 아니다. Let’s Verify Step by Step은 단계별 정답 확률을 모두 곱했다.
실제 구현에서는 수치 언더플로를 피하려고 로그 확률의 합을 쓸 수 있다.
집계 방식은 PRM의 정의가 아니라 시스템의 선택이다. 점수가 얼마나 잘 보정됐는지, 풀이 길이에 따른 편향은 없는지 검증한 뒤 정해야 한다.
Best-of-N 리랭킹을 직접 구현해 보기
아래 코드는 PRM이 이미 계산했다고 가정한 단계별 점수로 가장 믿을 만한 후보를 고른다. 별도 라이브러리는 필요하지 않으며 Python 3.10 이상에서 실행할 수 있다.
from dataclasses import dataclass
from math import log, prod
from typing import Literal


@dataclass(frozen=True)
class Candidate:
    name: str
    text: str
    step_scores: list[float]


def chain_score(
    scores: list[float],
    method: Literal["product", "minimum", "mean"] = "product",
) -> float:
    if not scores:
        raise ValueError("step_scores must not be empty")

    if any(score < 0.0 or score > 1.0 for score in scores):
        raise ValueError("every step score must be between 0 and 1")

    if method == "product":
        epsilon = 1e-8
        return sum(log(max(score, epsilon)) for score in scores)

    if method == "minimum":
        return min(scores)

    return sum(scores) / len(scores)


def select_best(
    candidates: list[Candidate],
    method: Literal["product", "minimum", "mean"] = "product",
) -> Candidate:
    if not candidates:
        raise ValueError("candidates must not be empty")

    return max(
        candidates,
        key=lambda candidate: chain_score(
            candidate.step_scores,
            method,
        ),
    )


candidates = [
    Candidate(
        name="A",
        text="Candidate A",
        step_scores=[0.98, 0.91, 0.12],
    ),
    Candidate(
        name="B",
        text="Candidate B",
        step_scores=[0.94, 0.92, 0.90],
    ),
    Candidate(
        name="C",
        text="Candidate C",
        step_scores=[0.99, 0.40, 0.96],
    ),
]

for candidate in candidates:
    probability = prod(candidate.step_scores)
    print(f"{candidate.name}: product={probability:.3f}")

selected = select_best(candidates, method="product")
print(f"selected: {selected.name}")
예상 출력은 다음과 같다.
A: product=0.107
B: product=0.778
C: product=0.380
selected: B
후보 A는 앞의 두 단계 점수가 높지만 마지막 단계가 0.12에 그친다. 확률을 곱하면 이 오류 하나가 전체 체인 점수를 크게 낮춘다. 후보 B에는 가장 높은 단일 점수가 없지만 모든 단계가 안정적으로 높아서 최종 후보로 선택된다.
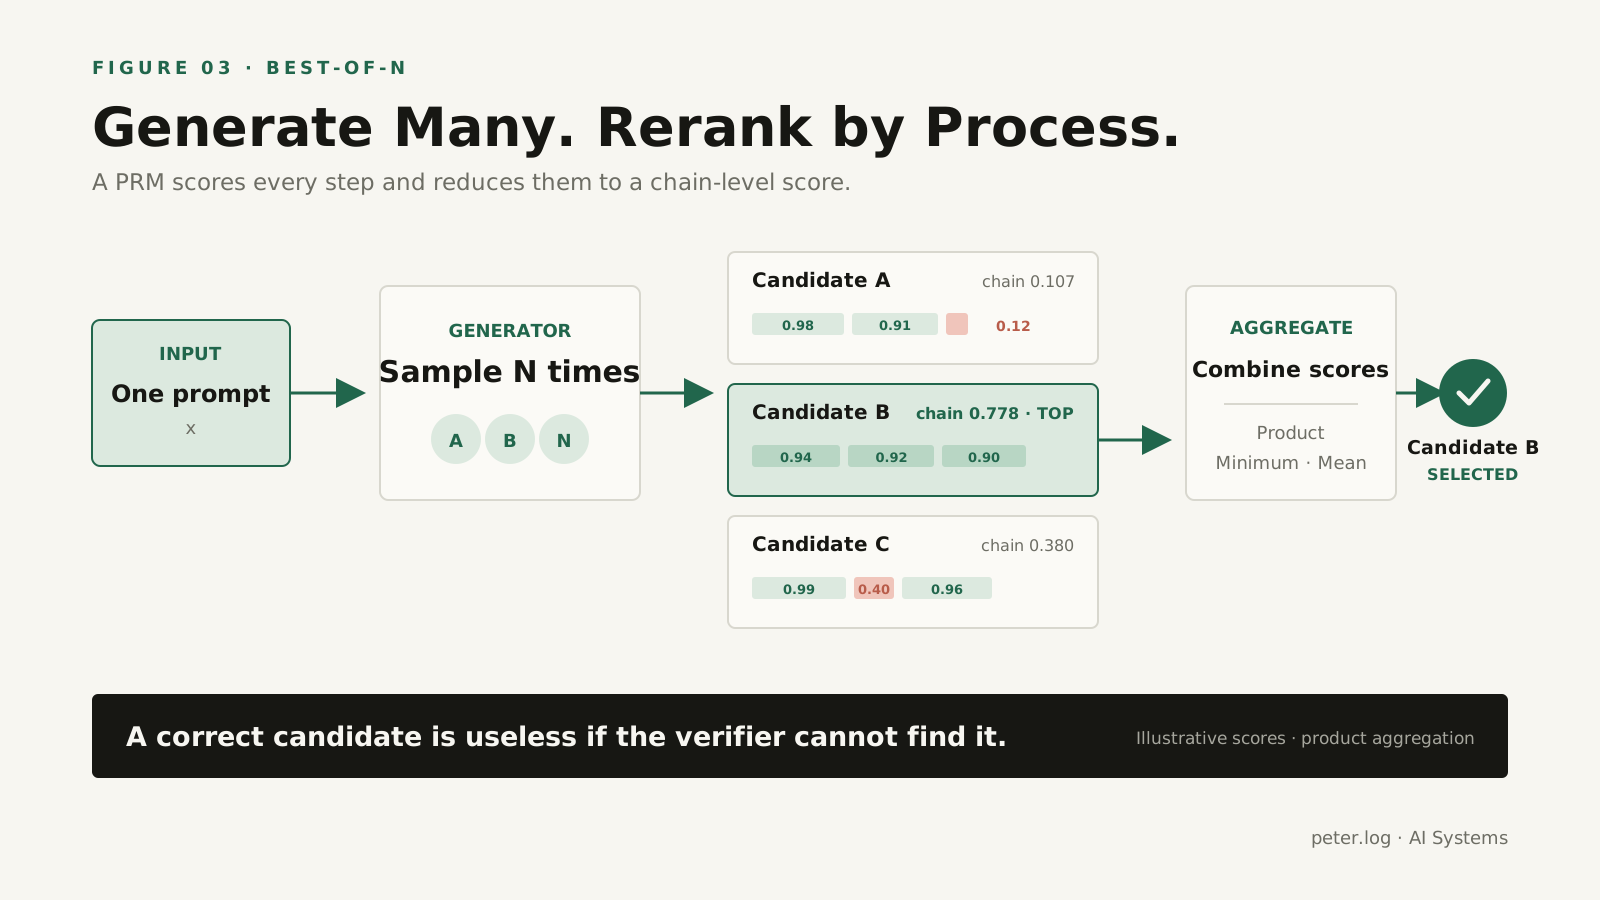
Figure 3. 후보 안에 정답이 있어도 검증기가 찾아내지 못하면 Best-of-N의 성능은 오르지 않는다.
이 코드는 PRM 자체를 구현하지 않는다. PRM이 반환했다고 가정한 점수를 합쳐 후보를 고르는 부분만 떼어낸 예제다. 실제 시스템에서는 점수가 실제 정확도와 잘 맞는지, 풀이 길이에 따른 편향은 없는지부터 확인해야 한다. 집계 방식을 바꿨을 때 순위가 어떻게 달라지는지, 생성 모델과 PRM이 같은 실패 패턴을 공유하지 않는지도 살펴볼 필요가 있다. 후보 수를 늘렸는데 선택 성능은 그대로라면 병목은 생성 모델보다 검증기에 있을 가능성이 높다.
PRM800K 데이터는 어떻게 생겼을까
PRM800K 공식 저장소에는 MATH 문제에 대해 모델이 만든 풀이와 각 단계의 인간 평가가 JSONL 형식으로 들어 있다. 정제된 학습 데이터는 약 7만 5천 개의 풀이와 80만 개 수준의 단계별 레이블로 구성된다.
구조를 단순화하면 다음과 같다.
{
  "question": {
    "problem": "Find the largest k such that 2^k divides 100!."
  },
  "label": {
    "steps": [
      {
        "completions": [
          {
            "text": "Count the powers of 2 in 100!.",
            "rating": 1
          }
        ]
      },
      {
        "completions": [
          {
            "text": "50 + 25 + 12 + 6 + 3 = 96.",
            "rating": -1
          }
        ]
      }
    ],
    "finish_reason": "found_error"
  }
}
이 예시는 이해를 돕기 위해 필드를 줄였다. 실제 데이터에는 라벨러, 생성 세대, 품질 관리 여부 같은 메타데이터도 담긴다.
PRM800K의 라벨러는 풀이에 있는 모든 오류를 찾지 않았다. 최초로 잘못된 단계까지만 평가했다. 최종 답이 틀렸다는 정보와 함께 오류가 시작된 위치를 남기기 위한 방식이다.
액티브 러닝은 PRM이 속는 오답을 고른다
단계별 라벨링은 비싸다. 최종 답을 확인하는 작업과 풀이 전체를 읽으며 최초 오류를 찾는 작업에는 필요한 시간이 다르다. 풀이가 길거나 전문 지식이 필요하면 격차가 더 벌어진다.
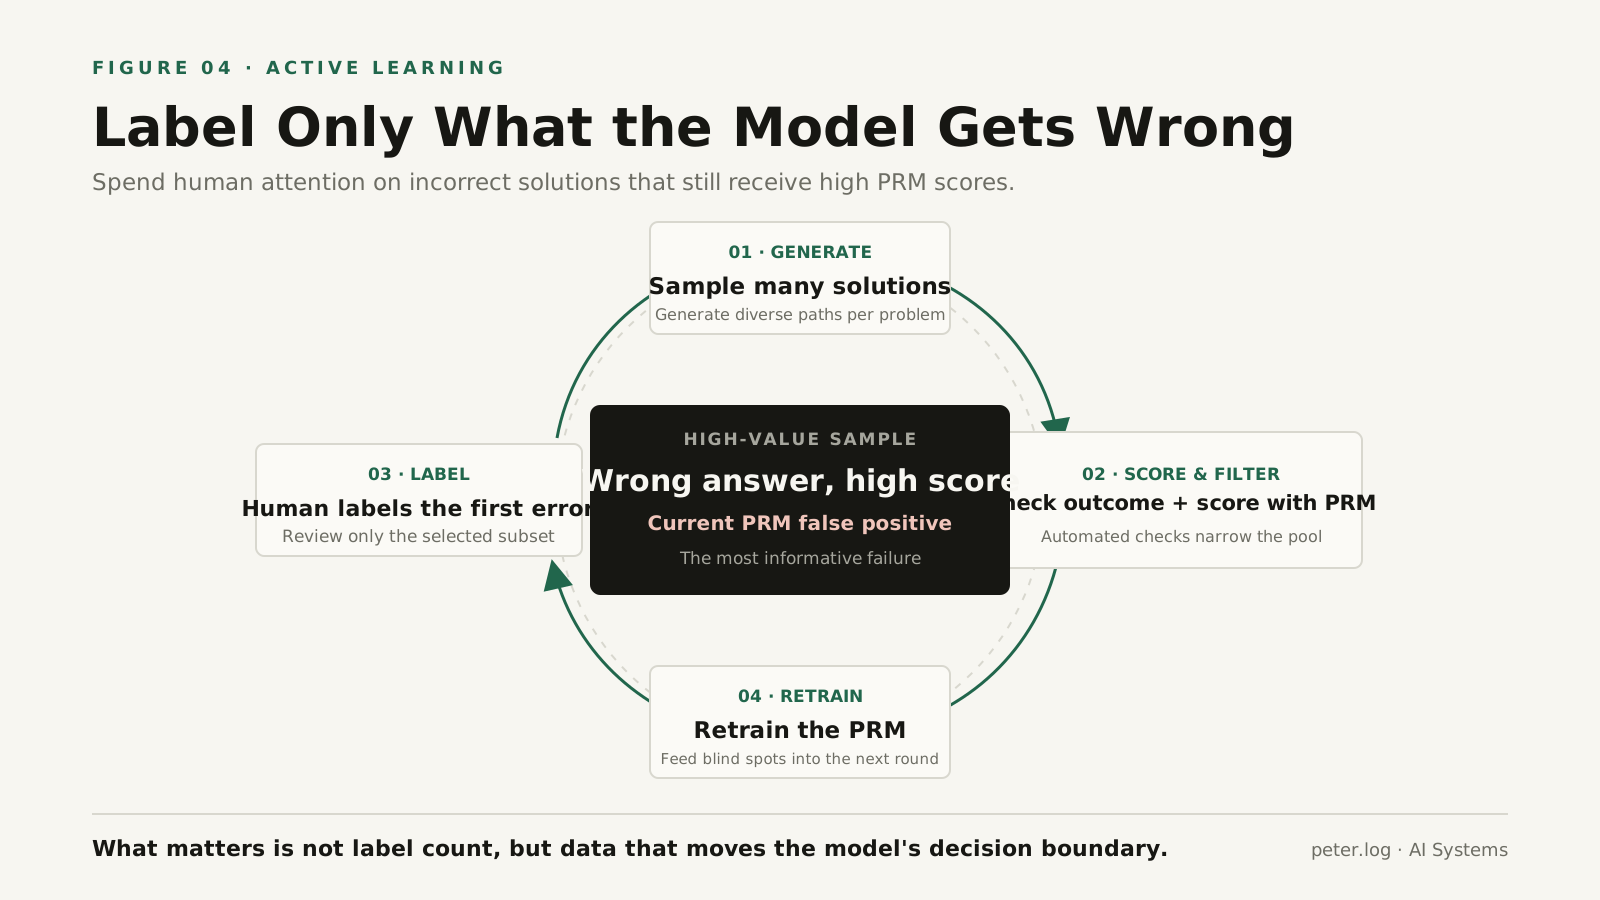
Figure 4. 액티브 러닝은 이미 잘 구분하는 쉬운 오답보다 현재 PRM을 속이는 오답에 라벨링 예산을 집중한다.
PRM을 위한 액티브 러닝은 많은 풀이를 생성하는 데서 시작한다. 자동 채점으로 최종 답이 틀린 풀이를 찾고, 현재 PRM으로 이 풀이들의 점수를 계산한다. 여기서 오답인데도 높은 점수를 받은 풀이만 추린다. 사람이 해당 풀이의 최초 오류를 표시하면 그 데이터로 PRM을 다시 학습한다.
오답인데 점수가 높다는 것은 현재 PRM이 그 풀이를 올바르다고 착각했다는 뜻이다. 이런 False Positive는 이미 낮은 점수를 받은 명백한 오답보다 학습 가치가 높다.
Let’s Verify Step by Step의 소규모 대체 실험에서 이 선택 전략은 균일한 라벨링보다 약 2.6배 높은 데이터 효율을 보였다. 다만 대규모 인간 라벨링 전체를 직접 비교한 결과는 아니다. 큰 PRM을 라벨링 오라클로 삼아 작은 PRM을 학습한 제한된 실험에서 측정한 값이다.
사람의 단계별 레이블을 줄이는 연구들
사람이 모든 단계에 직접 레이블을 붙이지 않는 방법도 연구되고 있다. Math-Shepherd는 특정 단계 이후의 풀이를 여러 번 생성하고 최종 정답 도달 여부로 중간 단계의 품질을 추정한다. Free Process Rewards without Process Labels은 결과 수준의 레이블에서 암묵적인 과정 보상을 얻는 방법을 다룬다.
라벨링 비용은 낮출 수 있지만 검증 비용까지 사라지지는 않는다. 자동 정답 판정기가 틀리면 그 오류가 과정 레이블로 옮겨간다. 잘못된 과정으로 우연히 정답에 도달한 경로도 긍정적으로 평가될 수 있다. 생성 모델과 검증 모델이 비슷한 오류를 공유하거나, 특정 벤치마크에서 얻은 과정 보상이 다른 도메인에서는 통하지 않을 가능성도 있다.
자동 과정 감독은 사람을 완전히 빼는 방법이라기보다 사람이 검토할 후보를 줄이는 방법으로 보는 편이 안전하다.
코딩과 에이전트 시스템에서는 검증기를 계층화한다
수학은 최종 답을 자동으로 비교하기 쉽다. 코딩과 데이터 분석, 브라우저 에이전트 작업에는 하나의 정답만 존재하지 않는다.
코딩 에이전트의 작업은 요구사항 분석에서 시작해 관련 파일 탐색, 변경 계획 수립, 코드 수정, 타입 검사, 테스트 실행, 회귀 여부 확인으로 이어질 수 있다. 이 모든 과정을 PRM 하나에 맡기기보다는 서로 다른 검증기를 겹쳐 쓰는 편이 현실적이다.
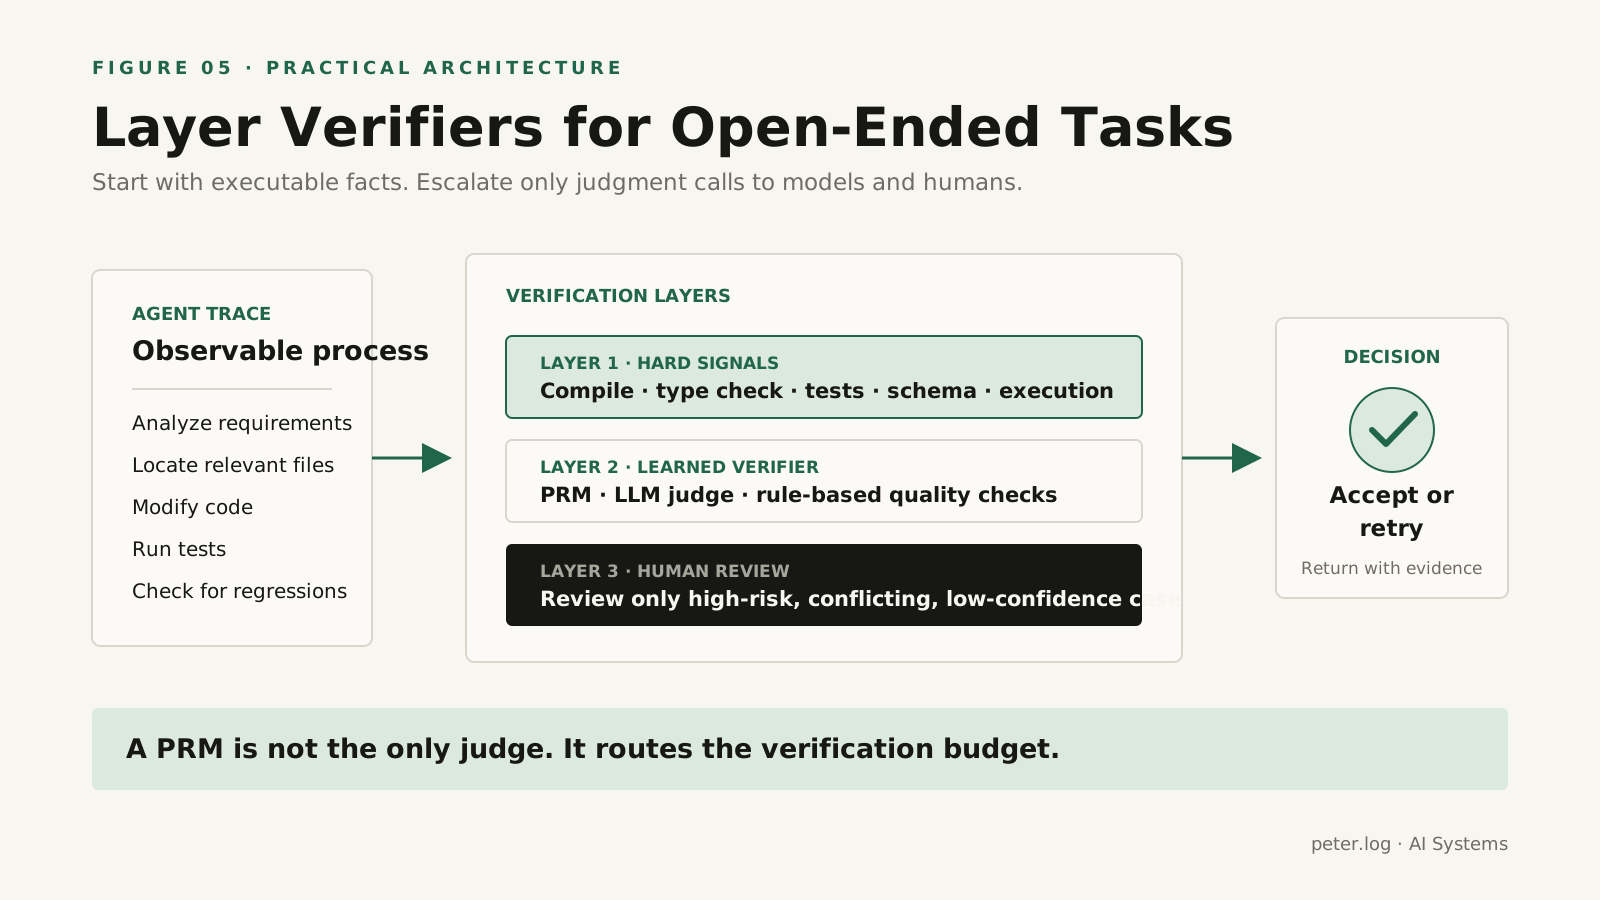
Figure 5. 실행 가능한 사실은 결정론적 검증기로 확인한다. 주관적인 판단이나 불확실성이 높은 사례만 학습된 검증기와 사람에게 넘긴다.
가장 먼저 볼 것은 실행 결과다. 컴파일과 타입 검사, 단위·통합 테스트, 데이터 스키마, 보안·정적 분석, 성능과 메모리 사용량, 기존 동작의 회귀 여부는 자연어 판단보다 강한 증거다.
실행만으로 확인하기 어려운 항목은 PRM이나 LLM 평가기가 맡을 수 있다. 요구사항을 제대로 해석했는지, 수정 범위가 불필요하게 넓지 않은지, 선택한 설계가 기존 구조와 어울리는지 같은 판단이다. LLM 평가기에는 위치 편향과 장황한 답변 선호, 자기 모델 선호가 생길 수 있다. 관련 한계는 Judging LLM-as-a-Judge에서 확인할 수 있다.
외부 사용자나 데이터에 큰 영향을 주는 작업, 검증기끼리 판단이 충돌한 경우, PRM이 학습하지 않은 분포의 입력은 사람이 확인해야 한다. 되돌리기 어려운 변경이나 보안·금전적 위험이 걸린 작업도 마찬가지다. PRM은 모든 판단을 대신하는 심판보다 검증 비용을 어디에 배분할지 정하는 라우터에 가깝다.
PRM을 쓰기 전에 확인할 조건
| 상황 | 권장 방법 |
|---|---|
| 하나의 문제에서 여러 추론 후보를 생성할 수 있다 | PRM 기반 Best-of-N을 고려한다 |
| 중간 오류 하나가 이후 결과를 모두 망칠 수 있다 | 단계별 PRM이 유리하다 |
| 완성되지 않은 경로를 비교해야 한다 | PRM을 Search Value로 사용할 수 있다 |
| 정답을 프로그램으로 정확히 검증할 수 있다 | PRM보다 결정론적 검증기를 우선한다 |
| 답변이 한 단계로 끝난다 | ORM이나 단순 검증으로 충분할 수 있다 |
| 단계 경계를 일관되게 정의하기 어렵다 | PRM 도입 비용이 커질 수 있다 |
| 잘못된 판단의 비용이 매우 크다 | PRM과 인간 검토를 함께 사용한다 |
도입 전에 무엇을 한 단계로 볼지부터 정해야 한다. 단계별 정답을 누가 판정하며 PRM의 오류는 어떤 검증 데이터로 찾을지도 필요하다. 후보 수를 늘릴 때 선택 정확도가 함께 오르는지 측정하고, 잘못된 선택이 발생했을 때 사람이 개입할 지점도 마련해야 한다.
이 질문에 답하기 어렵다면 PRM을 학습하기 전에 작업 과정과 검증 기준부터 구조화하는 편이 낫다.
PRM도 검증이 필요하다
수학 풀이로 학습한 PRM이 코딩이나 데이터 분석 과정을 정확하게 평가하리라는 보장은 없다. 생성 모델과 마찬가지로 검증 모델도 입력 분포와 배포 환경에 맞춰 평가해야 한다.
보상 해킹도 경계해야 한다. 생성 모델은 문제를 잘 푸는 대신 PRM이 좋아하는 표현이나 풀이 형식을 학습할 수 있다. PRM 점수만 최적화하지 말고 최종 실행 결과와 독립적인 평가셋을 함께 봐야 한다.
집계 방식에 따라 후보 순위도 바뀐다. 확률의 곱은 긴 풀이에 불리할 수 있고, 최솟값은 잘못 보정된 점수 하나에 민감하다. 평균은 치명적인 오류를 희석한다. 직관으로 하나를 고르기보다 실제 후보 선택 정확도를 비교해야 한다.
PRM은 외부로 표현된 풀이 단계나 도구 사용 기록을 평가한다. 모델 내부에서 실제로 어떤 계산이 일어났는지를 직접 읽지는 못한다. 높은 점수를 받은 설명이 모델 내부의 사고 과정을 그대로 보여준다고 단정할 수 없는 이유다.
마치며
추론 연산량을 늘리면 정답이 후보군에 들어갈 가능성은 높아진다. 그러나 실제 성능은 그 후보를 고르는 검증기의 정확도에 가로막힐 수 있다. ORM은 최종 결과를 평가하고 PRM은 각 추론 단계를 평가한다. 액티브 러닝은 PRM이 높은 점수를 준 오답에 라벨링 자원을 집중한다. 코딩과 에이전트 시스템에서는 실행 검증, PRM, 인간 검토를 계층적으로 조합해야 한다.
좋은 추론 시스템은 답을 무작정 많이 만들지 않는다. 잘못된 경로를 일찍 발견하고 남은 연산량을 가능성 높은 경로에 다시 쓴다. PRM은 그 판단을 돕는 도구다.
참고 자료
Scaling Laws for Neural Language Models, Self-Consistency Improves Chain of Thought Reasoning in Language Models, Solving Math Word Problems with Process- and Outcome-Based Feedback, Let’s Verify Step by Step, PRM800K 공식 저장소, Math-Shepherd, Large Language Monkeys, Scaling LLM Test-Time Compute Optimally, Free Process Rewards without Process Labels
이 글에 대한 생각을 남겨주세요.
GitHub 계정으로 로그인하면 댓글과 반응을 남길 수 있습니다.